Σε αυτό το κεφάλαιο, εξετάζουμε τη διωνυμική κατανομή (binomial distribution) και τη στενή συγγενή της, την κατανομή Bernoulli (Bernoulli distribution), οι οποίες είναι και οι δύο διακριτές κατανομές πιθανότητας. Αυτό σημαίνει ότι αφορούν αποτελέσματα που παίρνουν συγκεκριμένες, διακριτές τιμές.
Έχουμε ήδη καλύψει βασικές ιδέες για τις κατανομές πιθανότητας, τις συναρτήσεις πυκνότητας και την προσομοίωση σε προηγούμενα κεφάλαια, όπως το Κεφάλαιο Στατιστικές κατανομές. Εδώ, συνεχίζουμε να χτίζουμε πάνω σε αυτή τη βάση.
Σε όλο το κεφάλαιο, θα δούμε επίσης πώς σημαντικές έννοιες, όπως το κεντρικό οριακό θεώρημα, εμφανίζονται σε αυτό το πλαίσιο, βοηθώντας μας να καταλάβουμε πώς η διωνυμική κατανομή συνδέεται με την κανονική κατανομή υπό ορισμένες προϋποθέσεις. Επιπλέον, θα εξετάσουμε τις βασικές ιδιότητες αυτών των κατανομών, όπως οι παράμετροι και το συνολικό τους σχήμα. Θα καλύψουμε επίσης τα κύρια στατιστικά τους μέτρα και θα δείξουμε πώς κάνουμε προσομοιώσεις και υπολογισμούς με αυτές τις κατανομές χρησιμοποιώντας την Python.
Πότε συναντάμε την κατανομή Bernoulli;
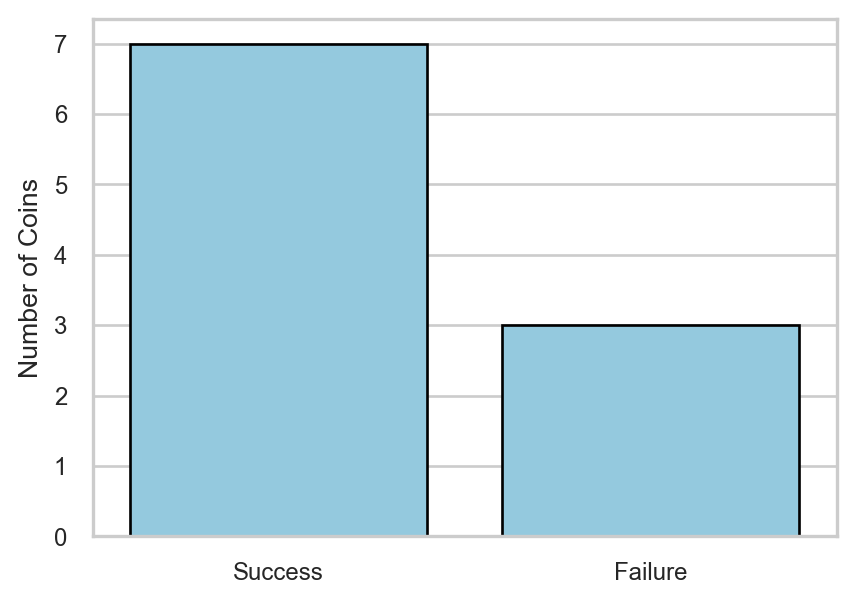
Ας ξεκινήσουμε με ένα απλό παράδειγμα ρίψης νομίσματος. Ας υποθέσουμε ότι έχουμε 10 αμερόληπτα νομίσματα, όπου κάθε πλευρά έχει πιθανότητα 50%, και τα ρίχνουμε όλα μαζί. Αν ένα νόμισμα φέρει κορώνα, καταγράφουμε μια επιτυχία (τιμή 1)· αν φέρει γράμματα, καταγράφουμε μια αποτυχία (τιμή 0).
# Εισαγωγή βιβλιοθηκώνimport numpy as npfrom scipy.stats import bernoulli# Ορισμός του seednp.random.seed(12345)# Προσομοίωση 10 δοκιμών Bernoulli με πιθανότητα p = 0.5bernoulli_sim = bernoulli.rvs(p =0.5, size =10)# Εμφάνιση των αποτελεσμάτωνbernoulli_sim
array([1, 0, 0, 0, 1, 1, 1, 1, 1, 1])
Μπορούμε να απεικονίσουμε τα αποτελέσματα αυτού του μικρού πειράματος ως εξής:
Εικόνα 11.1: Κατανομή των αποτελεσμάτων από 10 προσομοιωμένες ρίψεις νομίσματος.
Κάθε ρίψη νομίσματος ακολουθεί μια κατανομή Bernoulli, δηλαδή μια κατανομή που περιγράφει το αποτέλεσμα μιας μεμονωμένης δοκιμής, το οποίο είναι είτε επιτυχία (1) είτε αποτυχία (0). Παρόλο που η πραγματική πιθανότητα επιτυχίας είναι 50%, τα ύψη των ράβδων στο διάγραμμα μπορεί να διαφέρουν αισθητά λόγω του μικρού μεγέθους του δείγματος. Ακόμη και μια διαφορά ενός ή δύο αποτελεσμάτων έχει ορατή επίδραση.
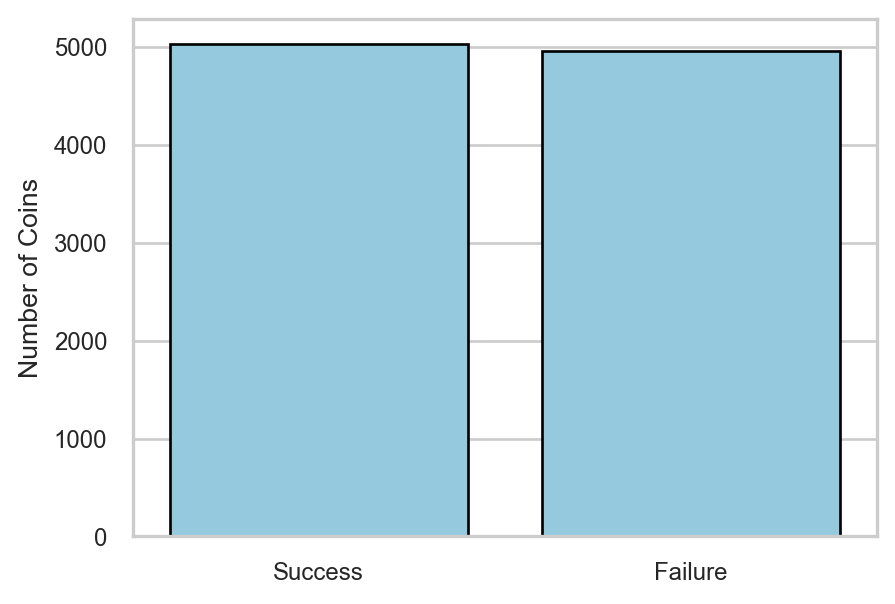
Ωστόσο, με ένα πολύ μεγαλύτερο δείγμα, αυτή η μεταβλητότητα εξομαλύνεται. Ο νόμος των μεγάλων αριθμών μάς λέει ότι η παρατηρούμενη αναλογία θα συγκλίνει στην πραγματική πιθανότητα καθώς αυξάνεται ο αριθμός των δοκιμών (Casella & Berger, 2002). Ας προσομοιώσουμε 10,000 ρίψεις νομίσματος για να το δούμε στην πράξη:
Εικόνα 11.2: Κατανομή των αποτελεσμάτων από 10,000 προσομοιωμένες ρίψεις νομίσματος.
Τώρα οι δύο ράβδοι είναι σχεδόν ίσες, η καθεμία γύρω στις 5,000, όπως ακριβώς θα περιμέναμε με πραγματική πιθανότητα 50%.
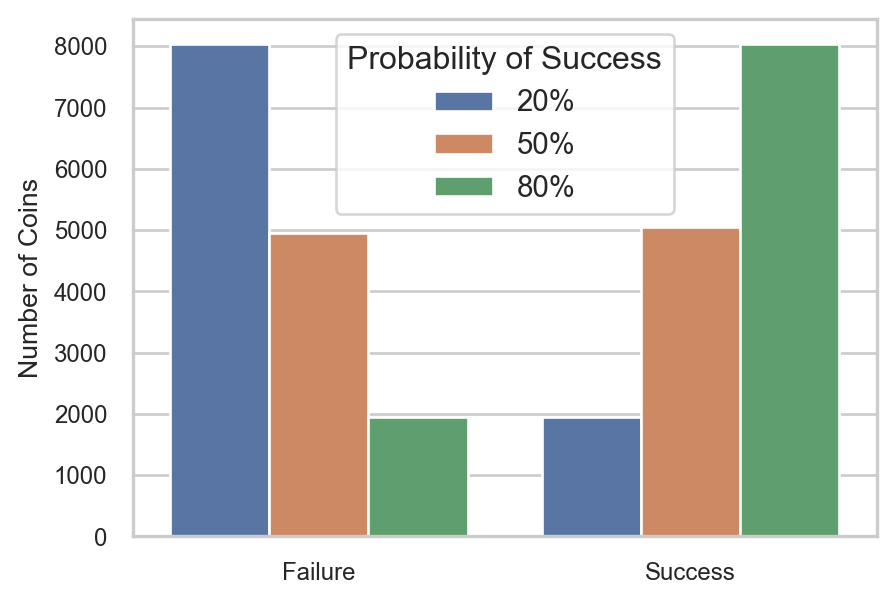
Τι γίνεται όμως αν η πιθανότητα επιτυχίας δεν είναι 50%; Ας το εξετάσουμε απεικονίζοντας κατανομές Bernoulli με πιθανότητες 20%, 50% και 80%:
Εικόνα 11.3: Αποτελέσματα ρίψεων νομίσματος με διαφορετικές πιθανότητες επιτυχίας.
Όταν η πιθανότητα επιτυχίας είναι 20%, περίπου 8,000 αποτελέσματα (από τα 10,000) είναι αποτυχίες. Όταν είναι 80%, περίπου 8,000 είναι επιτυχίες.
Ποιες είναι οι παράμετροι και το σχήμα της κατανομής Bernoulli;
Η κατανομή Bernoulli είναι μία από τις πιο απλές αλλά και πιο θεμελιώδεις κατανομές πιθανότητας στη στατιστική (Ross, 2014). Περιγράφει το αποτέλεσμα μιας μεμονωμένης δοκιμής που καταλήγει είτε σε επιτυχία είτε σε αποτυχία, οι οποίες συνήθως κωδικοποιούνται ως 1 και 0 αντίστοιχα.
Για να δηλώσουμε ότι μια μεταβλητή \(X\) ακολουθεί κατανομή Bernoulli, χρησιμοποιούμε τον εξής συμβολισμό:
\[X \sim \text{Bernoulli}(p)\]
Εδώ, το \(p\) είναι η πιθανότητα επιτυχίας (probability of success) και είναι η μόνη παράμετρος που ορίζει την κατανομή. Η πιθανότητα αποτυχίας είναι απλώς \(1 - p\), επειδή οι πιθανότητες πρέπει να αθροίζουν στο 1.
Επειδή η κατανομή Bernoulli είναι διακριτή (παίρνει μόνο συγκεκριμένες τιμές, 0 ή 1), ορίζεται μέσω μιας συνάρτησης μάζας πιθανότητας (probability mass function, PMF), η οποία αποδίδει πιθανότητες σε διακριτά αποτελέσματα, σε αντίθεση με τη συνάρτηση πυκνότητας πιθανότητας (PDF) που χρησιμοποιείται στις συνεχείς κατανομές.
Η PMF της κατανομής Bernoulli είναι:
\[P(X = x) = p^x \cdot (1 - p)^{1-x}\]
όπου το \(x\) μπορεί να πάρει μόνο τις τιμές 0 και 1 (μαθηματικά, \(x \in \{0,1\}\)).
Αυτός ο συμπαγής τύπος καλύπτει και τα δύο πιθανά αποτελέσματα:
Αν \(x = 1\):
\[P(X = 1) = p^1 \cdot (1 - p)^{1 - 1} = p\]
Αν \(x = 0\):
\[P(X = 0) = p^0 \cdot (1 - p)^{1 - 0} = 1 - p\]
Στην κατανομή Bernoulli, η αναμενόμενη τιμή μάς λέει τι θα παίρναμε κατά μέσο όρο αν επαναλαμβάναμε τη μεμονωμένη δοκιμή πολλές φορές. Είναι απλώς:
\[E[X] = p\]
Αυτό σημαίνει ότι, αν η πιθανότητα επιτυχίας είναι 0.7, η αναμενόμενη τιμή είναι 0.7. Μακροπρόθεσμα, περιμένουμε το 70% των δοκιμών να καταλήξει σε επιτυχία.
Το variance μιας κατανομής Bernoulli δείχνει πόσο διακυμαίνονται τα αποτελέσματα γύρω από την αναμενόμενη τιμή. Υπολογίζεται ως εξής:
\[Var[X] = p \cdot (1 - p)\]
Έτσι, αν \(p = 0.5\), τότε \(Var[X] = 0.5 \cdot 0.5 = 0.25\). Αυτό μας λέει ότι, όταν η πιθανότητα επιτυχίας είναι ισορροπημένη (όπως 50%), η μεταβλητότητα είναι η μεγαλύτερη δυνατή. Αν το \(p\) είναι πολύ κοντά στο 0 ή στο 1, το variance είναι μικρότερο, επειδή τα αποτελέσματα γίνονται πιο προβλέψιμα.
Ας το συνδέσουμε με το παράδειγμα της ρίψης νομίσματος. Αν η πιθανότητα να φέρουμε κορώνα είναι 20% και η κορώνα θεωρείται επιτυχία:
\(P(X = 1) = p = 20\%\)
\(P(X = 0) = 1 - p = 1 - 20\% = 80\%\)
Άρα, υπάρχει 20% πιθανότητα επιτυχίας και 80% πιθανότητα αποτυχίας. Αυτές οι τιμές είναι ακριβείς πιθανότητες, κάτι που αποτελεί βασικό διακριτικό γνώρισμα των PMFs στις διακριτές κατανομές. Αντίθετα, στις συνεχείς κατανομές οι πιθανότητες δίνονται από το εμβαδόν κάτω από την PDF σε ένα διάστημα και όχι σε ακριβή σημεία.
Πότε συναντάμε τη διωνυμική κατανομή;
Στην κατανομή Bernoulli ασχοληθήκαμε με μία μεμονωμένη δοκιμή, εξετάζοντας ένα παράδειγμα όπου ρίχνουμε ένα νόμισμα και παρατηρούμε αν φέρνει κορώνα (επιτυχία) ή γράμματα (αποτυχία). Τι γίνεται όμως αν επαναλάβουμε αυτή τη διαδικασία πολλές φορές και μετρήσουμε τον συνολικό αριθμό επιτυχιών; Σε αυτή την περίπτωση, η κατανομή που προκύπτει είναι μια διωνυμική κατανομή (binomial distribution).
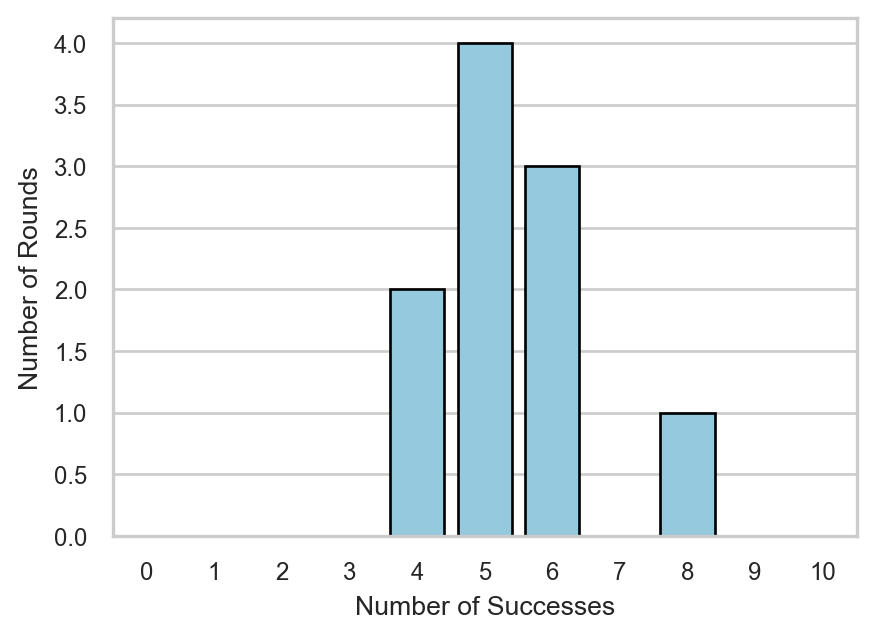
Ας επιστρέψουμε στο παράδειγμα της ρίψης νομισμάτων. Ας υποθέσουμε ότι η πιθανότητα να φέρουμε κορώνα (επιτυχία) είναι 50%. Αυτή τη φορά, ρίχνουμε 10 νομίσματα σε καθέναν από 10 γύρους και σε κάθε γύρο μετράμε πόσες φορές φέραμε κορώνα:
from scipy.stats import binom# Ορισμός του seednp.random.seed(123)# Προσομοίωση 10 γύρων με 10 νομίσματα και πιθανότητα p = 0.5binomial_sim = binom.rvs(n =10, p =0.5, size =10)# Εμφάνιση των αποτελεσμάτωνbinomial_sim[:6]
array([6, 4, 4, 5, 6, 5])
Εμφανίζεται το αποτέλεσμα για τους πρώτους έξι γύρους. Για παράδειγμα, η τιμή 4 σημαίνει ότι φέραμε 4 φορές κορώνα στις 10 ρίψεις νομίσματος εκείνου του γύρου. Η κατανομή αυτών των αποτελεσμάτων απεικονίζεται παρακάτω:
Εικόνα 11.4: Αριθμός εμφανίσεων κορώνας σε 10 γύρους των 10 ρίψεων νομίσματος.
Εδώ, ο άξονας x δείχνει τον αριθμό των επιτυχιών (από 0 έως 10) και ο άξονας y δείχνει πόσοι γύροι είχαν τον κάθε αριθμό επιτυχιών. Παρατηρούμε ότι οι 5 επιτυχίες ανά γύρο είναι αρκετά συχνές. Αυτό συμβαίνει επειδή η πιθανότητα επιτυχίας ορίστηκε στο 50%, οπότε οι 5 στις 10 επιτυχίες είναι το πιο αναμενόμενο αποτέλεσμα.
Επομένως, η διωνυμική κατανομή είναι μια κατανομή που μετρά τον αριθμό των επιτυχιών σε έναν σταθερό αριθμό ανεξάρτητων δοκιμών Bernoulli (Ross, 2014). Διαισθητικά, περιγράφει πόσες επιτυχίες μπορούμε να περιμένουμε όταν επαναλαμβάνουμε το ίδιο πείραμα ναι/όχι πολλές φορές υπό τις ίδιες συνθήκες.
Ποιες είναι οι παράμετροι και το σχήμα της διωνυμικής κατανομής;
Αν μια τυχαία μεταβλητή \(X\) ακολουθεί διωνυμική κατανομή, γράφουμε:
\[X \sim \text{Binomial}(n, p)\]
Η διωνυμική κατανομή έχει δύο παραμέτρους:
\(n\): ο αριθμός των ανεξάρτητων δοκιμών (π.χ. ο αριθμός των ρίψεων νομίσματος σε έναν γύρο)
\(p\): η πιθανότητα επιτυχίας σε μία μεμονωμένη δοκιμή (π.χ. η πιθανότητα να φέρουμε κορώνα)
Επειδή είναι διακριτή κατανομή, η διωνυμική κατανομή χρησιμοποιεί επίσης μια συνάρτηση μάζας πιθανότητας (PMF) αντί για συνάρτηση πυκνότητας πιθανότητας. Η PMF είναι:
όπου \(x \in \{0,1,2,...,n\}\), που σημαίνει ότι το \(x\) μπορεί να πάρει οποιαδήποτε τιμή από το 0 έως τον αριθμό των ανεξάρτητων δοκιμών (π.χ. τον αριθμό των νομισμάτων).
Το δεξί μέλος της PMF μάς είναι γνωστό από την κατανομή Bernoulli. Δίνει την πιθανότητα μιας συγκεκριμένης ακολουθίας με \(x\) επιτυχίες και \(n-x\) αποτυχίες. Το νέο στοιχείο εδώ είναι ο διωνυμικός συντελεστής (binomial coefficient), που γράφεται ως \(\binom{n}{x}\) και μας λέει με πόσους διαφορετικούς τρόπους μπορούμε να επιλέξουμε \(x\) επιτυχίες από \(n\) δοκιμές. Με άλλα λόγια, λαμβάνει υπόψη τους διαφορετικούς συνδυασμούς αποτελεσμάτων που οδηγούν στον ίδιο αριθμό επιτυχιών.
Η παραγοντική συνάρτηση στη διωνυμική κατανομή
Ο διωνυμικός συντελεστής υπολογίζεται με την παραγοντική συνάρτηση (factorial function):
\[\binom{n}{x} = \frac{n!}{x! \cdot (n - x)!}\]
• Το \(x!\) είναι ο αριθμός των τρόπων με τους οποίους μπορούμε να διατάξουμε τις \(x\) επιτυχίες.
• Το \((n-x)!\) είναι ο αριθμός των τρόπων με τους οποίους μπορούμε να διατάξουμε τις \(n-x\) αποτυχίες.
• Το \(n!\) είναι ο αριθμός των τρόπων με τους οποίους μπορούμε να διατάξουμε και τις \(n\) δοκιμές.
Αυτός ο τύπος δίνει τον αριθμό των μοναδικών συνδυασμών \(x\) επιτυχιών σε \(n\) συνολικές δοκιμές, αγνοώντας τη σειρά με την οποία εμφανίζονται οι επιτυχίες.
Για παράδειγμα, ας υποθέσουμε ότι έχουμε 3 νομίσματα με τις ετικέτες A, B και C και θέλουμε να μάθουμε με πόσους διαφορετικούς τρόπους μπορούμε να φέρουμε κορώνα σε δύο από τα τρία νομίσματα. Οι έγκυροι συνδυασμοί είναι:
• A και B
• A και C
• B και C
Αυτό δίνει συνολικά 3 συνδυασμούς, κάτι που μπορούμε να επιβεβαιώσουμε με τον τύπο:
Η παραγοντική συνάρτηση μάς βοηθά να κάνουμε αυτόν τον υπολογισμό αποδοτικά, ακόμη κι όταν οι αριθμοί γίνονται μεγάλοι.
Όταν \(n = 1\), η διωνυμική κατανομή ουσιαστικά ανάγεται στην κατανομή Bernoulli. Σε αυτή την περίπτωση, κάνουμε μία μόνο δοκιμή, οπότε ο αριθμός των επιτυχιών μπορεί να είναι μόνο 0 ή 1.
Όπως και στην κατανομή Bernoulli, η αναμενόμενη τιμή μάς λέει τι θα παίρναμε κατά μέσο όρο αν επαναλαμβάναμε ολόκληρο το πείραμα πολλές φορές. Για τη διωνυμική κατανομή:
\[E[X] = n \cdot p\]
Αυτό σημαίνει ότι, αν ρίξουμε 10 νομίσματα με πιθανότητα 40% για κορώνα, ο αναμενόμενος αριθμός εμφανίσεων κορώνας είναι \(10 \cdot 0.4 = 4\). Αυτό δεν σημαίνει ότι θα φέρνουμε πάντα ακριβώς 4 φορές κορώνα· σημαίνει απλώς ότι το 4 είναι ο μακροπρόθεσμος μέσος αριθμός εμφανίσεων κορώνας σε πολλές επαναλήψεις του πειράματος.
Το variance μιας διωνυμικής κατανομής μάς λέει πόσο τείνει να διακυμαίνεται ο αριθμός των επιτυχιών γύρω από την αναμενόμενη τιμή:
\[Var[X] = n \cdot p \cdot (1 - p)\]
Αν \(n = 10\) και \(p = 0.5\), τότε:
\[Var[X] = 10 \cdot 0.5 \cdot 0.5 = 2.5\]
Αυτό μας βοηθά να κατανοήσουμε τη διασπορά της κατανομής. Όσο πιο μακριά από το 0.5 βρίσκεται το \(p\), τόσο μικρότερο γίνεται το variance, καθώς τα αποτελέσματα γίνονται πιο προβλέψιμα.
Για να δούμε πώς μπορούμε να χρησιμοποιήσουμε την PMF στην πράξη, ας υποθέσουμε ότι ρίχνουμε 10 νομίσματα (άρα \(n = 10\)) και ότι η πιθανότητα να φέρουμε κορώνα είναι 50% (άρα \(p = 0.5\)). Τότε η πιθανότητα να φέρουμε ακριβώς 6 φορές κορώνα είναι:
Άρα, όταν ρίχνουμε 10 νομίσματα με πιθανότητα επιτυχίας 50%, υπάρχει περίπου 20.5% πιθανότητα να φέρουμε ακριβώς 6 φορές κορώνα.
Όπως και στην περίπτωση της κατανομής Bernoulli, η PMF της διωνυμικής κατανομής μάς δίνει πραγματικές πιθανότητες για κάθε πιθανό αριθμό επιτυχιών.
Υπολογισμοί και προσομοιώσεις στην Python
Όπως και για την κανονική κατανομή, το module scipy.stats περιλαμβάνει distribution objects για την κατανομή Bernoulli και τη διωνυμική κατανομή. Για υπενθύμιση, οι βασικές μέθοδοι είναι:
pmf(): για τη συνάρτηση μάζας πιθανότητας (probability mass function), η οποία δίνει το ύψος (ή τη μάζα) της κατανομής σε μια δεδομένη τιμή.
cdf(): για την αθροιστική συνάρτηση κατανομής (cumulative distribution function), η οποία δίνει την πιθανότητα να παρατηρήσουμε μια τιμή μικρότερη ή ίση με ένα δεδομένο σημείο.
ppf(): για τη συνάρτηση ποσοστιαίου σημείου (percent-point function, η αντίστροφη της CDF), η οποία επιστρέφει την τιμή που αντιστοιχεί σε μια δεδομένη πιθανότητα.
rvs(): για τα random variates (προσομοίωση), η οποία παράγει τυχαία δείγματα από την κατανομή.
Παρόλο που έχουμε ήδη εισαγάγει τα objects bernoulli και binom, τα εισάγουμε ξανά για λόγους παρουσίασης.
Ας ξεκινήσουμε προσομοιώνοντας 10,000 γύρους με ρίψη 10 νομισμάτων, όπου η πιθανότητα να φέρουμε κορώνα (επιτυχία) είναι 30%. Χρησιμοποιούμε τη μέθοδο rvs() του object binom, θέτοντας n = 10, size = 10000 και p = 0.3, και αποθηκεύουμε τα αποτελέσματα σε ένα object με όνομα binomial_sim. Σημειώστε ότι το όρισμα size εδώ αναφέρεται στον αριθμό των γύρων (πόσες φορές επαναλαμβάνουμε τις ρίψεις των 10 νομισμάτων) και όχι στον αριθμό των νομισμάτων που ρίχνουμε σε κάθε γύρο, ο οποίος ορίζεται από το όρισμα n:
from scipy.stats import binom# Ορισμός του seednp.random.seed(555)# Προσομοίωση από διωνυμική κατανομήbinomial_sim = binom.rvs(n =10, p =0.3, size =10000)# Εμφάνιση των πρώτων τιμώνbinomial_sim[:6]
array([4, 1, 5, 4, 3, 1])
Ας απεικονίσουμε τώρα την κατανομή:
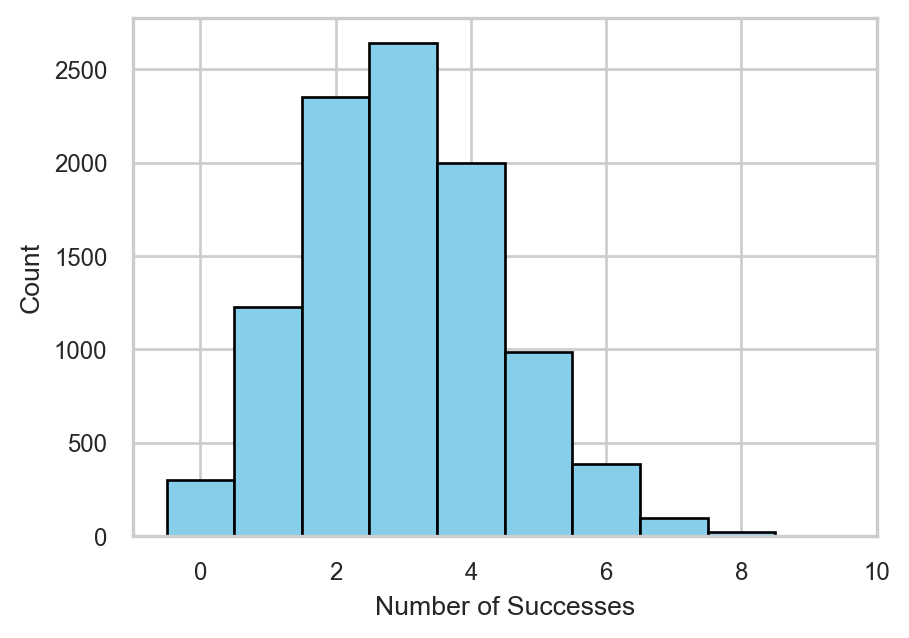
Εικόνα 11.5: Διωνυμική κατανομή 10,000 γύρων των 10 ρίψεων νομίσματος.
Βλέπουμε ότι το πιο συχνό αποτέλεσμα είναι οι 3 επιτυχίες, κάτι που συμφωνεί με αυτό που περιμέναμε: το 30% του 10 είναι 3.
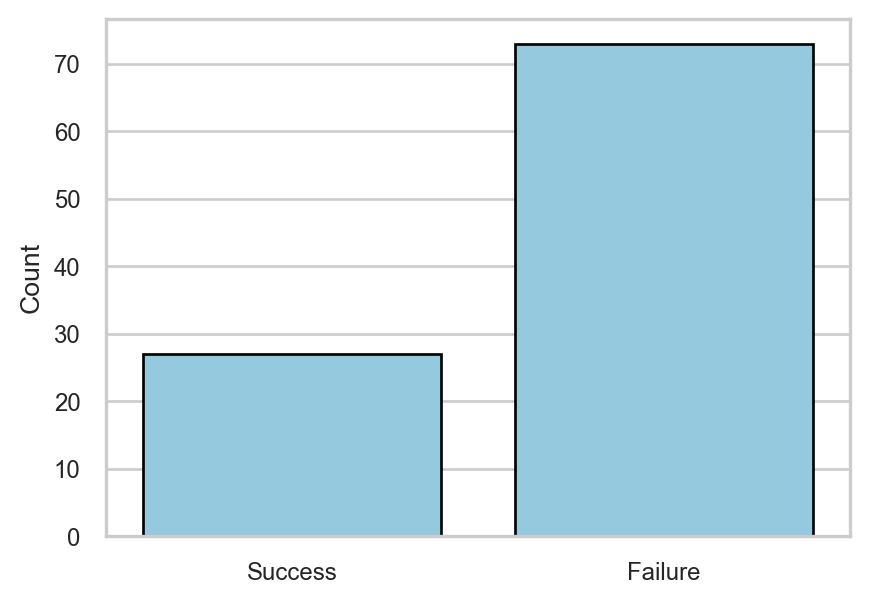
Όσον αφορά την κατανομή Bernoulli, χρησιμοποιούμε τη μέθοδο rvs() του distribution object bernoulli. Στην κλήση αυτής της μεθόδου, θέτουμε το όρισμα size στο 100 για να προσομοιώσουμε 100 ανεξάρτητες δοκιμές Bernoulli και το όρισμα p στο 0.3, που είναι η πιθανότητα επιτυχίας:
from scipy.stats import bernoulli# Ορισμός του seednp.random.seed(555)# Προσομοίωση ανεξάρτητων δοκιμών Bernoullibernoulli_sim = bernoulli.rvs(p =0.3, size =100)# Εμφάνιση των πρώτων τιμώνbernoulli_sim[:6]
Όπως αναφέραμε νωρίτερα, η συνάρτηση μάζας πιθανότητας (PMF) μάς επιτρέπει να υπολογίσουμε απευθείας την πιθανότητα να παρατηρήσουμε έναν συγκεκριμένο αριθμό επιτυχιών, δεδομένου ενός αριθμού δοκιμών και μιας σταθερής πιθανότητας επιτυχίας σε κάθε δοκιμή.
Για παράδειγμα, ας υποθέσουμε ότι θέλουμε να βρούμε την πιθανότητα να έχουμε ακριβώς 3 επιτυχίες σε 10 ρίψεις νομίσματος, όπου η πιθανότητα επιτυχίας σε κάθε ρίψη είναι 30%. Μπορούμε να χρησιμοποιήσουμε τη μέθοδο pmf() του binom, θέτοντας k = 3 (τον αριθμό των επιτυχιών), n = 10 και p = 0.3:
# Υπολογισμός της πιθανότητας για 3 επιτυχίες με την PMFbinom.pmf(k =3, n =10, p =0.3)
np.float64(0.2668279319999998)
Το αποτέλεσμα μας λέει ότι η πιθανότητα να έχουμε ακριβώς 3 επιτυχίες είναι περίπου 26.68%. Αυτό συμφωνεί με τον θεωρητικό τύπο της PMF:
Είναι σημαντικό να μη συγχέουμε την PMF με την αναμενόμενη τιμή. Η PMF δίνει την πιθανότητα ενός συγκεκριμένου αποτελέσματος, όπως το να έχουμε ακριβώς 3 επιτυχίες σε 10 δοκιμές. Στην περίπτωσή μας, αυτή είναι περίπου 26.68%. Η αναμενόμενη τιμή, από την άλλη πλευρά, είναι ο μακροπρόθεσμος μέσος αριθμός επιτυχιών. Υπολογίζεται ως εξής:
\[E[X] = n \times p = 10 \times 0.3 = 3\]
Αυτό σημαίνει ότι, αν επαναλάβουμε το πείραμα πολλές φορές, ο μέσος αριθμός επιτυχιών θα είναι γύρω στο 3.
Επειδή έχουμε ήδη προσομοιώσει αυτό το σενάριο με το binomial_sim και τα δεδομένα μας είναι διακριτά, μπορούμε να εκτιμήσουμε την ίδια πιθανότητα εμπειρικά. Για να το κάνουμε αυτό, μετράμε πόσες από τις 10,000 προσομοιώσεις κατέληξαν σε ακριβώς 3 επιτυχίες και διαιρούμε με τον συνολικό αριθμό των γύρων:
# Υπολογισμός της πιθανότητας για 3 επιτυχίες με το binomial_simsum(binomial_sim ==3) /len(binomial_sim)
np.float64(0.2641)
Αυτό το εμπειρικό αποτέλεσμα θα πρέπει να είναι κοντά στη θεωρητική πιθανότητα του 26.68%.
Στη συνέχεια, η μέθοδος cdf() μάς επιτρέπει να υπολογίσουμε αθροιστικές πιθανότητες, δηλαδή την πιθανότητα να έχουμε έως και έναν συγκεκριμένο αριθμό επιτυχιών. Για παράδειγμα, για να υπολογίσουμε την πιθανότητα να έχουμε 3 ή λιγότερες επιτυχίες:
# Υπολογισμός της αθροιστικής πιθανότητας για το πολύ 3 επιτυχίεςbinom.cdf(k =3, n =10, p =0.3)
np.float64(0.6496107184000001)
Για να το επαληθεύσουμε με την προσομοίωσή μας, υπολογίζουμε το ποσοστό των γύρων στο binomial_sim όπου ο αριθμός των επιτυχιών είναι μικρότερος ή ίσος με 3:
# Εκτίμηση της αθροιστικής πιθανότητας από την προσομοίωσηsum(binomial_sim <=3) /len(binomial_sim)
np.float64(0.6516)
Και πάλι, η προσομοίωση θα πρέπει να συμφωνεί πολύ με το θεωρητικό αποτέλεσμα.
Τέλος, η μέθοδος ppf() μάς επιτρέπει να δουλέψουμε προς την αντίθετη κατεύθυνση: βρίσκει τον μικρότερο αριθμό επιτυχιών για τον οποίο η αθροιστική πιθανότητα είναι τουλάχιστον ίση με μια δεδομένη τιμή. Για παράδειγμα, αν θέλουμε να βρούμε τον ελάχιστο αριθμό επιτυχιών που χρειάζεται για να καλυφθεί τουλάχιστον το 60% της κατανομής:
# Εύρεση του quantile που αντιστοιχεί στο 60ό percentilebinom.ppf(q =0.6, n =10, p =0.3)
np.float64(3.0)
Αυτό το αποτέλεσμα είναι διαισθητικά λογικό: νωρίτερα είδαμε ότι έως και 3 επιτυχίες καλύπτουν περίπου το 65% της κατανομής, ενώ έως και 2 επιτυχίες καλύπτουν μόνο περίπου το 38% (binom.cdf(k = 2, n = 10, p = 0.3)).
Από τη διωνυμική στην κανονική κατανομή
Στο προηγούμενο παράδειγμα, χρησιμοποιήσαμε πιθανότητα επιτυχίας 30%, κάτι που οδήγησε σε μια κατανομή με δεξιά ασυμμετρία. Αν είχαμε χρησιμοποιήσει 70%, η κατανομή θα είχε αριστερή ασυμμετρία. Ωστόσο, σε πολλά πραγματικά σενάρια—όπως η ρίψη ενός αμερόληπτου νομίσματος—η πιθανότητα επιτυχίας είναι 50%.
Ας επανέλθουμε στην προσομοίωση, αυτή τη φορά χρησιμοποιώντας μεγαλύτερο αριθμό δοκιμών (100 νομίσματα ανά γύρο) και θέτοντας την πιθανότητα επιτυχίας στο 0.5. Παρακάτω είναι ο κώδικας για αυτή την προσομοίωση και την απεικόνιση των αποτελεσμάτων:
# Ορισμός του seednp.random.seed(555)# Προσομοίωση διωνυμικής κατανομήςbinomial_sim = binom.rvs(n=100, p=0.5, size=10000)# Δημιουργία DataFramedf = pd.DataFrame({"x": binomial_sim})# Διάγραμμαplt.hist(df["x"], bins=range(df["x"].min(), df["x"].max() +2), color="skyblue", edgecolor="black")plt.xlabel("Number of Successes")plt.ylabel("Count")plt.show()
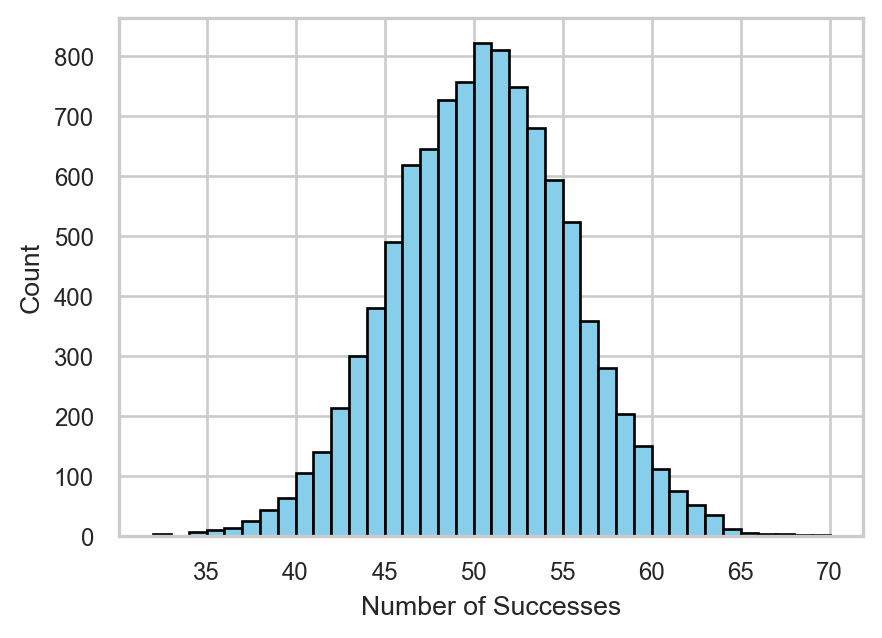
Εικόνα 11.7: Διωνυμική κατανομή που προσεγγίζει το σχήμα της κανονικής κατανομής.
Η κατανομή που προκύπτει είναι συμμετρική και σε σχήμα καμπάνας, μοιάζοντας πολύ με την κανονική κατανομή. Αυτό δεν είναι σύμπτωση. Σύμφωνα με το κεντρικό οριακό θεώρημα, όταν ο αριθμός των δοκιμών είναι μεγάλος και η πιθανότητα επιτυχίας δεν είναι πολύ κοντά στο 0 ή στο 1, η διωνυμική κατανομή τείνει να μοιάζει με κανονική κατανομή.
Για να το δείξουμε, ας υπολογίσουμε την πιθανότητα να έχουμε 40, 50 και 55 επιτυχίες χρησιμοποιώντας τη διωνυμική PMF:
# Υπολογισμός της ακριβούς διωνυμικής πιθανότητας για 40 επιτυχίεςbinom.pmf(k =40, n =100, p =0.5)
np.float64(0.010843866711638016)
# Υπολογισμός της ακριβούς διωνυμικής πιθανότητας για 50 επιτυχίεςbinom.pmf(k =50, n =100, p =0.5)
np.float64(0.07958923738717875)
# Υπολογισμός της ακριβούς διωνυμικής πιθανότητας για 55 επιτυχίεςbinom.pmf(k =55, n =100, p =0.5)
np.float64(0.04847429662643081)
Παρόλο που το 50 είναι το πιο πιθανό αποτέλεσμα, η πιθανότητά του είναι μόνο περίπου 8%. Με τόσους πολλούς πιθανούς συνδυασμούς, οι μεμονωμένες πιθανότητες γίνονται αρκετά μικρές, ακόμη και για τις κεντρικές τιμές.
Νωρίτερα συζητήσαμε τους τύπους για την αναμενόμενη τιμή και το variance μιας διωνυμικής κατανομής. Ας τα υπολογίσουμε τώρα:
# Αναμενόμενη τιμή: n * pexpected_value =100*0.5
# Εμφάνιση της αναμενόμενης τιμήςexpected_value
50.0
# Variance: n * p * (1 - p)variance =100*0.5* (1-0.5)
# Εμφάνιση του variancevariance
25.0
Χρησιμοποιώντας αυτές τις τιμές, μπορούμε τώρα να εκτιμήσουμε τη density για 40, 50 και 55 επιτυχίες με την κανονική κατανομή:
from scipy.stats import norm# Παράμετροι για την προσέγγιση της διωνυμικής κατανομήςmean =100*0.5sd = np.sqrt(100*0.5* (1-0.5))# Υπολογισμός της κανονικής προσέγγισης για 40 επιτυχίεςnorm.pdf(40, loc = mean, scale = sd)
np.float64(0.010798193302637612)
# Υπολογισμός της κανονικής προσέγγισης για 50 επιτυχίεςnorm.pdf(50, loc = mean, scale = sd)
np.float64(0.07978845608028654)
# Υπολογισμός της κανονικής προσέγγισης για 55 επιτυχίεςnorm.pdf(55, loc = mean, scale = sd)
np.float64(0.04839414490382867)
Η σύγκριση αυτών των τιμών με τα αποτελέσματα της binom.pmf() επιβεβαιώνει το επιχείρημά μας: όταν ο αριθμός των δοκιμών γίνεται μεγάλος και η πιθανότητα επιτυχίας δεν είναι πολύ κοντά στο 0 ή στο 1, η διωνυμική κατανομή μοιάζει πολύ με την κανονική κατανομή.
Ανακεφαλαίωση
Η κατανομή Bernoulli είναι ένα θεμελιώδες δομικό στοιχείο των πιθανοτήτων και της στατιστικής. Περιγράφει καταστάσεις με μόνο δύο πιθανά αποτελέσματα, όπως επιτυχία ή αποτυχία, ναι ή όχι, αληθές ή ψευδές. Η κατανόηση της κατανομής Bernoulli μάς βοηθά να κατανοήσουμε πιο σύνθετες έννοιες, όπως η διωνυμική κατανομή, η οποία επεκτείνει την ιδέα σε πολλαπλές επαναλαμβανόμενες δοκιμές.
Όταν ο αριθμός των δοκιμών σε μια διωνυμική κατανομή γίνεται μεγάλος, η διωνυμική κατανομή μπορεί να προσεγγιστεί πολύ καλά από την κανονική κατανομή. Αυτή η προσέγγιση είναι χρήσιμη, επειδή η κανονική κατανομή είναι μαθηματικά ευκολότερη στη χρήση και εμφανίζεται συχνά σε πραγματικά δεδομένα. Αυτή η σύνδεση δείχνει πώς η απλή διαδικασία Bernoulli συνδέεται με ευρύτερα, πιο σύνθετα στατιστικά μοντέλα.